
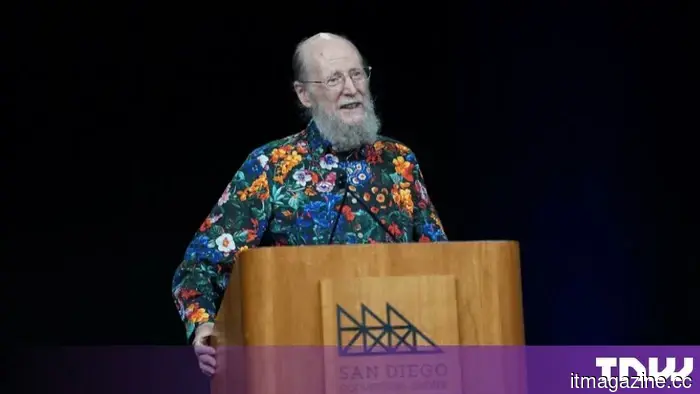
Победитель премии Тьюринга говорит, что решение отрасли по поводу нехватки данных — «большая ошибка»
Ричард Саттон считает, что ответ AI-индустрии на исчерпание обучающих данных является ошибкой, и он выбрал для этого резкое слово. “Это просто большая ошибка,” - сказал он о переходе к синтетическим данным в подкасте Sequoia Capital Training Data, опубликованном во вторник и ведущими которого являются Соня Хуан и Пэт Грейди. Это замечание имеет больший вес, чем большинство звуковых фрагментов из подкастов. Саттон разделил 2024 года премию Тьюринга с Эндрю Бартом за основание обучения с подкреплением, написал эссе The Bitter Lesson 2019 года, которое теперь цитирует половина области, и в июле покинул Keen Technologies Джона Кармака, чтобы открыть свою собственную лабораторию. Его возражение имеет два конкретных аспекта, а не универсальный вердикт. “Нет никакого способа получить синтетические данные для чужих умов,” - сказал он, а о моделировании физического мира: “Мир бесконечно сложен, и любое его моделирование является, по сути, микроскопическим.” Под этим лежит то, что он называет гипотезой большого мира, идеей о том, что реальность всегда больше, чем модель агента о ней, что делает любое моделирование потерей информации по своей сути. Второе возражение более тонкое, потому что кто-то должен решить, какие синтетические данные генерировать, и это возвращает человеческое суждение обратно в процесс, против которого предостерегала The Bitter Lesson. Вместо этого он хочет получить опытные данные, собранные агентом, действующим в своей среде, а не собранные заранее кем-либо. Эта тезис не нов, он был изложен с Дэвидом Сильвером в Welcome to the Era of Experience в апреле 2025 года, но ранее он не нацеливал его так прямо на синтетические данные. Причина, по которой индустрия стремится к ним, на самом деле не оспаривается. Epoch AI прогнозирует, что запас публичного человеческого текста, где-то около 300 триллионов токенов, будет полностью использован между 2026 и 2032 годами, и лаборатории с тех пор импровизируют. Часть этого импровизации является физической. AI-компании покупают и разрезают подержанные книги для текста до 2022 года, исходя из предположения, что все, что было опубликовано с тех пор, загрязнено машинным мусором. Недостаток не является только проблемой английского языка. Китайские лаборатории сталкиваются с той же стеной на своем языке, и довольно скоро. Существует рецензируемая поддержка для тревоги, которую выражает Саттон. В статье Nature 2024 года Ильи Шумайлова и коллег было установлено, что модели, обученные рекурсивно на своих собственных выходных данных, деградируют, эффект, который литература теперь называет model collapse. Однако опровержение также опубликовано, и это важно. Работа Маттиаса Герштграссера, Райлана Шеффера и соавторов показала, что коллапс зависит от замены человеческих данных синтетическими; где два типа данных накапливаются вместе, это не проявляется. На практике лаборатории давно вышли за рамки этого спора. Phi-4 от Microsoft обучалась на примерно 400 миллиардах синтетических токенов по 50 типам наборов данных, а Nvidia выпустила синтетический корпус предварительного обучения объемом около 10 триллионов токенов для своих моделей Nemotron. Эти области также являются теми, где возражение Саттона имеет наименьший вес, поскольку математика и код имеют проверяемые ответы таким образом, как это не относится к чужим умам. Его ограничения касаются моделирования людей и физических систем, а не генерации обучающих примеров как таковых. Андрей Карпаты сделал наиболее известный контрпример, утверждая, что языковые модели меньше похожи на животных, выросших через опыт, чем на призраков, дистиллированных из человеческого письма, и что их настройка является законным путем, а не неверным поворотом. Саттон, в свою очередь, сказал в подкасте, что язык составляет, возможно, четверть интеллекта. Он называет это следующим большим уроком, и Sequoia рада представить это как второй горький урок, что является аккуратной формулировкой для венчурной компании, которая также поддерживает новую лабораторию Дэвида Сильвера. Собственная лаборатория Саттона, соучредителем которой является его бывший студент Хуррам Джавед, нацелена на создание разума с триллионом параметров, который никогда не перестает учиться и работает на 20 ватт в течение пяти-десяти лет.
Другие статьи
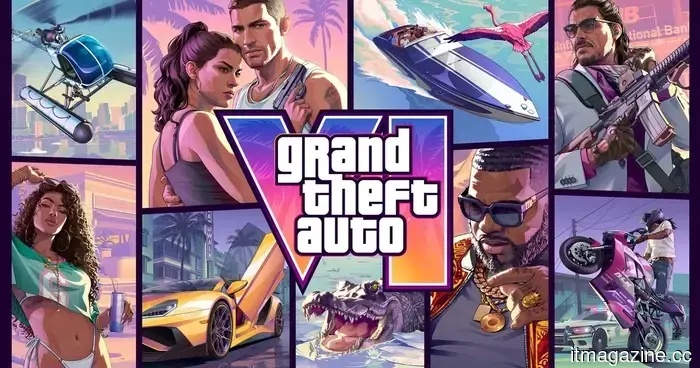 Новые утечки кадров GTA 6 показывают, как Джейсон бросает мяч в корзину и создает хаос на дороге.
Новые кадры GTA 6 утекли перед запланированным анонсом Rockstar, показывая Джейсона, играющего в баскетбол, водящего машину и взаимодействующего с системами, которые могут добавить больше глубины в игровой процесс.
 Alphabet привлекла 5,5 миллиарда австралийских долларов в Австралии, более чем удвоив рекорд, установленный Apple в 2015 году.
Alphabet оценил свои первые облигации в австралийских долларах в 5,5 млрд австралийских долларов (3,9 млрд долларов США), что стало крупнейшей продажей корпоративных облигаций в истории Австралии и увеличением по сравнению с ожидаемыми 5 млрд австралийских долларов.
 Новый режим бега Spotify поднимает плейлисты для тренировок на новый уровень
Новый режим бега Spotify может создать саундтрек для вашей тренировки, музыкальных предпочтений и даже вашего темпа бега.
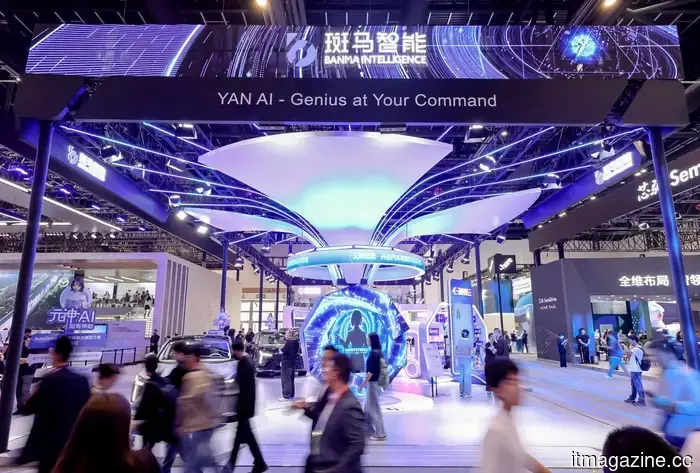 От умных кокпитов до автомобилей с искусственным интеллектом, Banma Intelligence нацелена на следующую волну автомобильного программного обеспечения.
По мере того как крупные модели ИИ ускоряют свою интеграцию в автомобили, конкурентная динамика интеллектуальных автомобилей меняется. В прошлом умные кокпиты
 ChatGPT получает подростковую версию, и у меня много вопросов.
Подростки уже используют ИИ для домашних заданий и многого другого. Новый опыт ChatGPT от OpenAI хочет убедиться, что они действительно учатся на этом — с серьезными ограничениями.
 Googlebook наконец-то получил дату запуска, и она ближе, чем вы ожидаете.
Google продемонстрирует Googlebook в Нью-Йорке 15 сентября, представив программное обеспечение на базе Gemini, родной код Android и ноутбуки от аппаратных партнеров.
Победитель премии Тьюринга говорит, что решение отрасли по поводу нехватки данных — «большая ошибка»
Ричард Саттон говорит, что переход отрасли на синтетические данные — это «большая ошибка». Его возражение более узкое и более интересное, чем предполагает заголовок.