
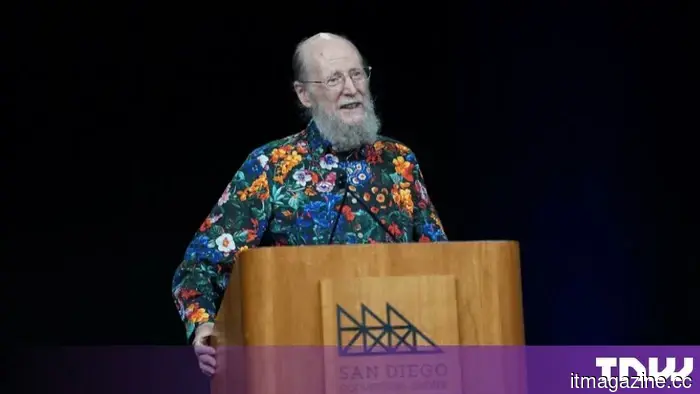
Un ganador del Premio Turing dice que la solución de la industria para quedarse sin datos es 'un gran error'
Richard Sutton piensa que la respuesta de la industria de la IA a la falta de datos de entrenamiento es un error, y ha elegido una palabra contundente para ello. “Eso es simplemente un gran error”, dijo sobre el giro hacia los datos sintéticos en el pódcast de Sequoia Capital, Training Data, publicado el martes y presentado por Sonya Huang y Pat Grady.
El comentario tiene más peso que la mayoría de los fragmentos de pódcast. Sutton compartió el Premio Turing 2024 con Andrew Barto por fundar el aprendizaje por refuerzo, escribió el ensayo de 2019 La Lección Amarga que la mitad del campo ahora cita a la otra mitad, y dejó Keen Technologies de John Carmack en julio para iniciar su propio laboratorio.
Su objeción tiene dos aristas específicas en lugar de un veredicto general. “No hay forma de que podamos tener datos sintéticos para las mentes de otras personas”, dijo, y sobre la simulación del mundo físico: “El mundo es infinitamente complejo, y cualquier simulación de él es como, microscópica”.
Debajo se encuentra lo que él llama la hipótesis del gran mundo, la idea de que la realidad siempre es más grande que el modelo de un agente sobre ella, lo que convierte a cualquier simulador en una compresión con pérdida por construcción.
Una segunda objeción es más sutil, porque alguien tiene que decidir qué datos sintéticos generar, y eso introduce el juicio humano de nuevo en exactamente el proceso contra el que La Lección Amarga advertía.
Lo que él quiere en su lugar son datos experienciales, recopilados por un agente que actúa en su entorno en lugar de ser ensamblados de antemano por alguien. La tesis no es nueva, habiendo sido expuesta con David Silver en Bienvenido a la Era de la Experiencia en abril de 2025, pero no la había dirigido anteriormente tan directamente hacia los datos sintéticos.
La razón de la industria para recurrir a ello no está realmente en disputa. Epoch AI proyecta que el stock de texto humano público, alrededor de 300 billones de tokens, se utilizará por completo entre 2026 y 2032, y los laboratorios han estado improvisando desde entonces.
Parte de esa improvisación es física. Las empresas de IA han estado comprando y cortando libros de segunda mano para texto anterior a 2022, con el razonamiento de que cualquier cosa publicada desde entonces está contaminada con desechos generados por máquinas.
Tampoco la escasez es solo un problema del idioma inglés. Los laboratorios chinos están enfrentándose a la misma pared en su propio idioma, y bastante antes.
Hay apoyo revisado por pares para la ansiedad que Sutton está expresando. Un artículo de Nature de 2024 por Ilia Shumailov y colegas encontró que los modelos entrenados recursivamente sobre su propia salida se degradan, un efecto que la literatura ahora llama colapso del modelo.
La refutación también está publicada, sin embargo, y aquí importa. Un trabajo de Matthias Gerstgrasser, Rylan Schaeffer y coautores encontró que el colapso depende de que los datos sintéticos reemplacen los datos humanos; donde los dos se acumulan uno al lado del otro, no se presenta.
En la práctica, los laboratorios han pasado mucho tiempo del argumento. El Phi-4 de Microsoft se entrenó con aproximadamente 400 mil millones de tokens sintéticos a través de 50 tipos de conjuntos de datos, y Nvidia ha lanzado un corpus de pre-entrenamiento sintético de aproximadamente 10 billones de tokens para sus modelos Nemotron.
Esos también son los dominios donde la objeción de Sutton tiene menos impacto, ya que las matemáticas y el código tienen respuestas verificables de una manera que las mentes de otras personas no. Sus límites son sobre modelar humanos y sistemas físicos, no sobre generar ejemplos de entrenamiento como tales.
Andrej Karpathy ha hecho el contraargumento más conocido, argumentando que los modelos de lenguaje son menos como animales desarrollados a través de la experiencia que fantasmas destilados de la escritura humana, y que afinarlos es un camino legítimo en lugar de un giro equivocado. Sutton, por su parte, dijo en el pódcast que el lenguaje representa quizás una cuarta parte de la inteligencia.
Él está llamando a esto la próxima gran lección, y Sequoia está feliz de presentarlo como una segunda lección amarga, lo que es un marco ordenado para una firma de capital de riesgo que también respalda el nuevo laboratorio de David Silver. El propio laboratorio de Sutton, cofundado con su exalumno Khurram Javed, tiene como objetivo una mente de un billón de parámetros que nunca deja de aprender y funciona con 20 vatios, dentro de cinco a diez años.
Otros artículos
 Pennsylvania acaba de convertirse en uno de los estados de EE. UU. más difíciles para construir un centro de datos.
La orden ejecutiva del gobernador Josh Shapiro elimina a los centros de datos de IA del proceso acelerado de permisos de Pensilvania y obliga a los desarrolladores a pagar sus propios costos de energía.
 Medly AI recauda 8 millones de dólares para poner un tutor de IA frente a cada estudiante de examen en el Reino Unido.
Medly AI ha recaudado 8 millones de dólares en una ronda semilla liderada por Felix Capital, semanas después de ganar un contrato del gobierno del Reino Unido por 300,000 libras para probar la tutoría de IA en alumnos que se están quedando atrás.
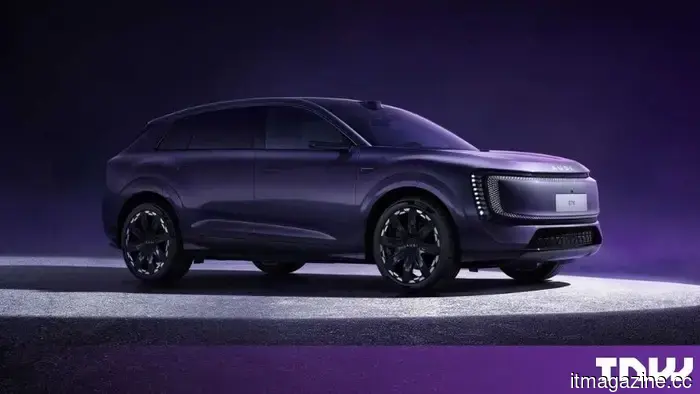 Los vehículos eléctricos exclusivos de Audi para China llegarán a Europa, y cuestan menos que los modelos locales.
Un importador alemán está trayendo los E5 y E7X de Audi, fabricados en China, a Europa, donde superan en precio a los propios modelos europeos de Audi por miles de euros.
 Las Mejores Sillas de Oficina Ergonómicas en 2026
Las largas horas en tu escritorio merecen más que una silla de oficina ordinaria. Ya sea que estés mejorando tu oficina en casa o reemplazando una silla envejecida, estas opciones ergonómicas están diseñadas para mantenerte cómodo y apoyado durante toda la jornada laboral.
 La alianza de IA de China sigue creciendo, justo cuando Washington dice a los países que elijan.
La Organización Mundial de Cooperación en IA de China ha crecido de 29 miembros a 38, basada en una doctrina de "soberanía digital" que presentó en la ONU en julio.
 El nuevo estándar de neumáticos de California es más estricto que el de Europa, que tiene uno desde 2012.
California ha aprobado el primer estándar de eficiencia de EE. UU. para neumáticos de reemplazo. Europa tiene un límite de resistencia a la rodadura desde 2012, y uno más laxo.
Un ganador del Premio Turing dice que la solución de la industria para quedarse sin datos es 'un gran error'
Richard Sutton dice que el giro de la industria hacia los datos sintéticos es “un gran error”. Su objeción es más estrecha y más interesante de lo que sugiere el titular.