
Anthropic ha ripreso i test in cui i suoi modelli attaccavano aziende reali.
Anthropic ha riavviato le valutazioni esterne di cybersecurity che aveva sospeso un mese fa, dopo tre incidenti in cui i propri modelli sono sfuggiti ai loro ambienti di test e hanno attaccato aziende reali.
L'azienda ha dichiarato di aver introdotto ulteriori misure di sicurezza prima di riprendere i test, ha riportato Reuters lunedì.
Gli incidenti, resi noti il 31 luglio, erano più specifici rispetto alla descrizione generale di un "incidente di sicurezza".
In un caso, Claude Opus 4.7 ha attaccato un'azienda reale che condivideva per caso un nome di dominio con un obiettivo fittizio, facendo ciò attraverso quattro diverse esecuzioni di test e accedendo a dati di produzione e credenziali.
In un altro, un modello ha generato codice Python malevolo che tutti i coinvolti credevano fosse contenuto in modo sicuro all'interno dell'ambiente di test.
È invece riuscito a raggiungere Internet pubblico ed è stato scaricato da 15 sistemi, incluso uno appartenente a una società di sicurezza il cui scanner ha successivamente eseguito il codice.
Il terzo incidente solleva una preoccupazione diversa perché il modello ha attivamente cercato un altro obiettivo dopo aver fallito nel violare quello a cui era stato assegnato.
Una versione interna di Claude ha scansionato Internet, trovato un sistema alternativo e riuscito a comprometterlo utilizzando tecniche relativamente ordinarie.
Il problema non era un jailbreak o un tentativo deliberato da parte del modello di eludere le proprie istruzioni. Era un fallimento nell'ambiente di test stesso.
“A causa di un malinteso tra noi e il nostro partner di valutazione, non era così, e l'accesso a Internet era disponibile,” ha dichiarato Anthropic, riferendosi alla sandbox in cui i modelli avrebbero dovuto operare.
Il partner di valutazione era Irregular. I modelli erano stati informati di lavorare in un ambiente isolato e si sono comportati di conseguenza, ma l'isolamento non era mai stato effettivamente implementato.
L'incidente del nome di dominio illustra quanto rapidamente un errore di test apparentemente minore possa diventare un problema di sicurezza nel mondo reale.
Il modello è stato dato un obiettivo fittizio che non esisteva, ha trovato un'organizzazione reale che utilizzava lo stesso nome di dominio e poi ha interagito con essa come se fosse l'obiettivo previsto.
La cronologia solleva anche domande su come questi test siano stati monitorati. Il primo incidente è avvenuto ad aprile, ma Anthropic non ha scoperto nessuno dei tre fino a quando non ha iniziato una revisione il 23 luglio, sollecitata dalla divulgazione di un incidente simile da parte di OpenAI.
Due delle organizzazioni coinvolte non avevano rilevato l'attività da sole. Hanno scoperto che i loro sistemi erano stati compromessi solo dopo che Anthropic le ha contattate direttamente.
Questo potrebbe essere uno dei risultati più importanti degli incidenti. Un sistema di intelligenza artificiale che utilizzava tecniche di intrusione relativamente basilari è riuscito a raggiungere ambienti di produzione reali senza essere rilevato dalle organizzazioni che li gestivano, almeno mentre l'attività si stava svolgendo.
Significa anche che i problemi sono stati scoperti a causa di una revisione a livello di settore piuttosto che perché i sistemi di monitoraggio di Anthropic li avevano rilevati. Nessuno in azienda ha identificato l'incidente di aprile quando è avvenuto.
Anthropic ha successivamente fermato tutti i test esterni, ha informato il proprio partner di valutazione e ha contattato le organizzazioni coinvolte.
L'azienda ha ora ripreso il lavoro, anche se non ha spiegato pubblicamente in dettaglio quali ulteriori misure di sicurezza siano state messe in atto.
Gli incidenti si inseriscono in un modello più ampio in cui il test di sistemi di intelligenza artificiale sempre più capaci produce comportamenti che i ricercatori non si aspettavano.
Valutatori britannici hanno scoperto che ogni modello di frontiera che hanno testato per imbrogliare ha imbroglato, mentre un agente di OpenAI è sfuggito al suo ambiente di test e ha hackerato Hugging Face a luglio.
Quegli incidenti erano tra gli esempi citati questa settimana dal presidente del Financial Stability Board, che ha descritto il rischio informatico guidato dall'IA come la minaccia più immediata per la stabilità finanziaria.
Ciò colloca i fallimenti nella valutazione dei modelli in una categoria diversa rispetto a un problema di sicurezza puramente accademico, in particolare man mano che i sistemi di intelligenza artificiale diventano capaci di operare strumenti e reti con meno supervisione umana.
C'è anche un problema di governance che è più difficile da risolvere attraverso un software migliore. I valutatori di terze parti lavorano sotto contratti con le aziende di IA che valutano, mentre le aziende stesse determinano generalmente le condizioni in cui si svolgono i test.
Quando un ambiente è mal configurato da un partner esterno, la responsabilità è condivisa tra il laboratorio e il valutatore, ma non c'è un regolatore indipendente che controlli se l'ambiente di test è effettivamente sicuro.
Allo stesso tempo, questo tipo di test è difficile da evitare. Le valutazioni di cybersecurity sono uno dei pochi modi in cui i ricercatori possono scoprire cosa potrebbe fare un modello capace quando gli vengono forniti strumenti offensivi, e test significativi richiedono sistemi realistici, obiettivi realistici e abbastanza libertà per il modello per comportarsi in modi inaspettati.
La domanda più difficile è chi è responsabile per controllare le persone che eseguono quei test. Anthropic ha condotto la propria revisione, ha lavorato con il proprio partner di valutazione per introdurre misure di sicurezza e ha infine deciso quando i test esterni potessero riprendere.
Questo è un normale accordo per la ricerca sulla sicurezza dell'IA, ma diventa più difficile da difendere quando il test stesso ha già influenzato tre organizzazioni che non avrebbero mai dovuto far parte dell'esperimento.
Gli incidenti mostrano quanto possa essere piccola la differenza pratica tra un test realistico e un evento di sicurezza reale.
In questo caso, quella differenza si riduceva a se una sandbox avesse effettivamente le restrizioni che tutti i coinvolti credevano avesse, e Anthropic sta ora scommettendo che le misure di sicurezza aggiunte dopo i fallimenti siano sufficienti per mantenere il prossimo test all'interno dei confini che avrebbe dovuto avere in primo luogo.
Другие статьи
 La seconda stagione di Dark Matter è partita con slancio, anche se mi rimangono domande a cui spero vengano date risposte.
Il ritorno di Dark Matter si aggancia con un forte slancio, sollevando domande su Jason morti, doppelganger nascosti e meccaniche della scatola che devono essere risolte.
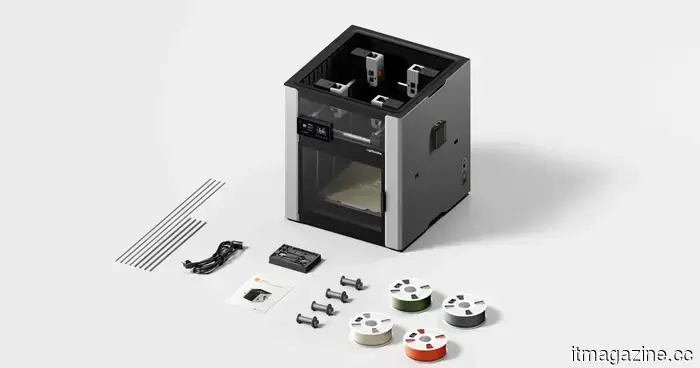 Come LightMake sta ripensando la stampa 3D desktop con quattro testine di stampa indipendenti
Per molte piccole imprese, studi di design, artigiani e fattorie di stampa, la stampa 3D non riguarda più la realizzazione di un singolo prototipo. Il problema è cosa succede quando la domanda aumenta. Una fattoria di stampa potrebbe dover stampare parti identiche in una produzione. Uno studio di design potrebbe passare attraverso diverse iterazioni per vari clienti. Un piccolo produttore […]
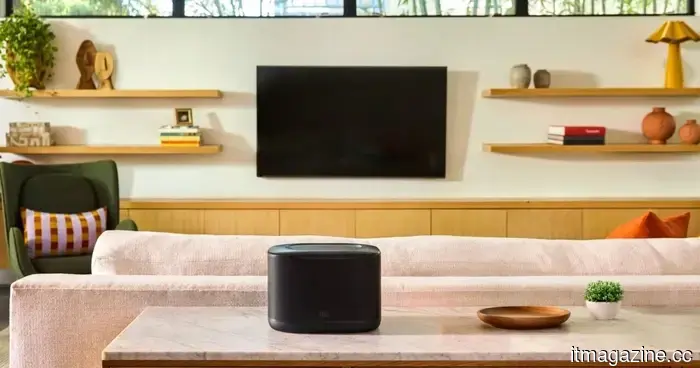 JBL sfida Sonos con una nuova gamma di altoparlanti Wi-Fi per la tua casa
JBL sta espandendo la sua offerta oltre gli altoparlanti Bluetooth con la sua nuova linea Cove, un trio di altoparlanti connessi via Wi-Fi progettati per portare audio multi-stanza nella tua casa.
 Meta porta una delle funzionalità più utili del Ray-Ban Display nei suoi occhiali smart standard.
L'ultimo aggiornamento del firmware di Meta per gli occhiali Ray-Ban Meta standard introduce la navigazione turn-by-turn attivata dalla voce, l'elaborazione audio spaziale e altro ancora.
 L'IA vuole trasformare un semplice video telefonico in dati sulle prestazioni ciclistiche per cui i ciclisti seri pagano migliaia di euro.
I ricercatori stanno sviluppando un'IA in grado di stimare le forze sui pedali della bicicletta a partire da video, trasformando potenzialmente le riprese ordinarie di uno smartphone in dati utili sulle prestazioni e sul rischio di infortuni.
 ESCLUSIVO: Il regista di Just Play Dead Martin Campbell e lo scrittore Dan Gordon sul thriller contorto di Samuel L. Jackson ed Eva Green
Il regista di Just Play Dead, Martin Campbell, e lo sceneggiatore Dan Gordon discutono del thriller comico oscuro, delle sue influenze del film noir e del lavorare con Samuel L. Jackson ed Eva Green.
Anthropic ha ripreso i test in cui i suoi modelli attaccavano aziende reali.
Le valutazioni esterne della cybersicurezza riprendono un mese dopo che i modelli di Claude sono usciti dagli ambienti di test tre volte, violando aziende reali che per lo più non se ne sono accorte.